电影评论情感分析:RNN循环网络原理及自然语言处理NLP应用

  1. 1. 电影评论情感分析案例描述
  2. 2. 自然语言处理基础知识
  3. 3. IMDB数据集获取与处理(非TF集成模式)
    1. 3.1. 非预设数据处理
    2. 3.2. 下载数据集及解压
    3. 3.3. 数据读取
    4. 3.4. 数据处理
    5. 3.5. 构建模型
  4. 4. 循环神经网络RNN与LSTM介绍

电影评论情感分析:RNN循环网络原理及自然语言处理NLP应用

电影评论情感分析案例描述

情感分析(sentiment analysis),又称意见挖掘、倾向性分析,是对带有情感色彩的主观性文本进行分析、处理、归纳和推理的过程。
本例使用IMDb网络电影数据集,对电影评论的情感倾向进行分析。https://www.imdb.com/
电影评论情感分析IMDb数据集
IMDb全称Internet Movie Database(互联网电影资料库),是一个关于电影演员、电影、电视节目、电视明星、电子游戏和电影制作的在线数据库。
利用模型进行预测
对影评文字进行数据预处理得到特征,通过特征建造深度学习模型,通过模型预测分出正面评价与负面评价

自然语言处理基础知识

分词
自然语言处理常见特征:
• 单独词
• 词的n元组
• 单独词或n元组出现的频率
• 词的词性
• 词的位置
……
结巴分词
• 三种分词模式:
① 精确模式:试图将句子最精确地切开,适合文本分析
② 全模式:把句子中所有的可以成词的词语都扫描出来, 速度非常快,但是不能解决歧义
③ 搜索引擎模式:在精确模式的基础上,对长词再次切分,提高召回率,适合用于搜索引擎分词
• 支持繁体分词
• 支持自定义词典
• jieba.cut 方法接受三个输入参数: 需要分词的字符串;cut_all 参数用来控制是否采用全模式;HMM 参数用来控制是否使用 HMM 模型
• jieba.cut_for_search 方法接受两个参数:需要分词的字符串;是否使用 HMM 模型。该方法适合用于搜索引擎构建倒排索引的分词
• jieba.cut 以及 jieba.cut_for_search 返回的结构都是一个可迭代的generator,可以使用 for 循环来获得分词后得到的每一个词语,或者用jieba.lcut 以及 jieba.lcut_for_search 直接返回 list
• 开发者可以指定自己自定义的词典,以便包含 jieba 词库里没有的词 • 用法: jieba.load_userdict(file_name)
• file_name 为文件类对象或自定义词典的路径
• 词典格式:一个词占一行;每一行分三部分:词语、词频(可省略)、词性(可省略),用空格隔开,顺序不可颠倒。 • file_name 若为路径或二进制方式打开的文件,则文件必须为 UTF-8 编码
词的数字化表示方法与词嵌入
词的表示方法
NLP的需要寻求恰当的文本表示方法
分词之后,词还需要表示成机器容易理解的形式,常见表示方法有:独热编码(One-Hot)
词嵌入
• 将词汇嵌入到低维的连续向量空间中,即词被表示为实数域上的向量
• 能捕捉到词汇间的联系,比如,通过计算两个词嵌入的余弦值得到两个词汇的相关程度
• 运算速度快
• 能提高情感分析、机器翻译等众多自然语言处理问题的效果
词嵌入(word embedding)
一个词嵌入是一个稠密浮点数向量(向量长度可以设置)
它们是可以训练的参数
一般词嵌入是8维(对于小型数据集)到1024维(大型数据集)
更高的维度嵌入可以捕获词之间更细的关系,但是需要更多数据去学习

常见的词嵌入模型有word2vec、GloVe等 word2vec
通过对具有数十亿词的新闻文章进行训练,Google提供了一组词向量的结果,可以从http://word2vec.googlecode.com/svn/trunk/获取
GloVe(Wikipedia 2014+ Gigaword 5)
GloVe词嵌入可以从下面地址获得:
https://nlp.stanford.edu/projects/glove/
如果想要训练中文文本,这里有一些预训练的中文词嵌入可用:
https://github.com/Embedding/Chinese-Word-Vectors

IMDB数据集获取与处理(非TF集成模式)

非预设数据处理

如果是自有数据,或者网络其他数据,需要写一套处理数据的程序
基本思路:
1 、获取数据,确定数据格式 规范;
2 、文字分词。英文分词可以按照空格分词,中文分词可以参考 jieba ;
3 、建立词索引表,给每个词一个数字索引 编号;
4 、段落文字转为词索引 向量;
5 、段度文字转为词嵌入

下载数据集及解压

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import os
import tarfile
import urllib.request

import tensorflow as tf
import numpy as np

import re
import string
from random import randint
#数据地址
url="http://ai.stanford.edu/~amaas/data/sentiment/aclImdb_v1.tar.gz"
#数据存放路径
filepath="data/aclImdb_vl.tar.gz"

#如果当前目录下不存在data文件夹,则建立
if not os.path.exists("data"):
os. makedirs("data")
#下载数据,80兆左右
if not os.path.isfile(filepath):
print ('downloading...')
result=urllib.request.urlretrieve(url,filepath)
print (' downloaded:' ,result)
else:
print(filepath,'is existed ! ')

#解压数据
if not os.path.exists("data/aclImdb") :
tfile=tarfile. open(filepath,"r:gz")
print (' extracting.. .')
result=tfile.extractall("data/")
print (' extraction completed')
else:
print("data/aclImdb is existed!")

数据读取

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
#将文本中不需要的字符清除,如html标签<br />
def remove_tags(text):
re_tag = re.compile(r'<[^>]+>')
return re_tag.sub('', text)

#读取文件
def read_files(filetype):
path = "data/aclImdb/"
file_list=[]
#读取正面评价的文件的路径,存到file_list列表里
positive_path=path + filetype+"/pos/"
for f in os.listdir(positive_path):
file_list+=[positive_path+f]
pos_files_num=len(file_list)
#读取负面评价的文件的路径,存到file_list列表里
negative_path=path + filetype+"/neg/"
for f in os.listdir(negative_path):
file_list+=[negative_path+f]
neg_files_num=len(file_list)-pos_files_num
print('read',filetype,'files:' , len(file_list))
print(pos_files_num,'pos files in',filetype,'files')
print (neg_files_num, 'neg files in',filetype, 'files')
#得到所有标签。标签用one-hot编码表示,正面评价标签为[1 0],负面评价标签为[0 1]
all_labels = ([[1,0]] * pos_files_num +[[0,1]] *neg_files_num)
#得到所有文本。
all_texts= []
for fi in file_list:
with open(fi, encoding='utf8') as file_input:
#文本中有<br/>这类html标签,将文本传入remove_tags函数
#函数里使用正则表达式可以将这样的标签清除掉。
all_texts +=[remove_tags(" ".join(file_input.readlines()))]
return all_labels, all_texts

#得到训练与测试用的标签和文本
train_labels,train_texts=read_files("train")
test_labels,test_texts=read_files("test")

#查看数据、标签
print("训练数据")
print("正面评价:")
print(train_texts[0])
print(train_labels[0])
print("负面评价:")
print(train_texts[12500])
print(train_labels[12500])
print("测试数据")
print("正面评价:")
print(test_texts[0])
print(test_labels[0])
print("负面评价:")
print(test_texts[12500])
print(test_labels[12500])

数据处理

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
import tensorflow.keras as keras
#建立词汇词典Token
token = keras.preprocessing.text.Tokenizer(num_words=4000)
token.fit_on_texts(train_texts)
#查看读取文档数量
token.document_count
#将单词映射为他们的排名或索引
print(token.word_index)
#将单词映射为它们在训练期间所出现的文档或文本数量
token.word_docs
#查看词汇出现的频次排名
print(token.word_counts)
#文字转数字列表
train_sequences = token.texts_to_sequences(train_texts)
test_sequences = token.texts_to_sequences(test_texts)

print(train_texts[0])

print(train_sequences[0])

x_train = keras.preprocessing.sequence.pad_sequences(train_sequences,
padding='post',truncating='post',maxlen=400)
x_test = keras.preprocessing.sequence.pad_sequences(test_sequences,
padding='post',truncating='post',maxlen=400)

x_train.shape
print(x_train[0])
#让转换后的数字列表长度相同
x_train = keras.preprocessing. sequence.pad_sequences(train_sequences,
padding='post',
truncating='post',
maxlen=400)
x_test = keras.preprocessing. sequence.pad_sequences(test_sequences,
padding='post',
truncating='post',
maxlen=400)
y_train=np.array(train_labels)
#要把标签改为ndarray格式
y_test=np.array(test_labels)

texts_to_sequences(texts)
texts:待转为序列的文本列表
返回值:序列的列表,列表中每个序列对应于一段输入文本
填充序列pad_sequences
keras.preprocessing.sequence.pad_sequences(sequences, maxlen=None,dtype=’int32’, padding=’pre’, truncating=’pre’, value=0.)
参数
sequences:浮点数或整数构成的两层嵌套列表
maxlen:None或整数,为序列的最大长度。大于此长度的序列将被截短,小于此长度的序列将填0.
dtype:返回的numpy array的数据类型
padding:‘pre’或‘post’,确定当需要补0时,在序列的起始还是结尾补
truncating:‘pre’或‘post’,确定当需要截断序列时,从起始还是结尾截断
value:浮点数,此值将在填充时代替默认的填充值0

构建模型

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
model = keras.models.Sequential()
model.add (keras.layers.Embedding(output_dim=32,
input_dim=4000,
input_length=400))
model.add(keras.layers.Flatten())
model.add(keras.layers.Dense(units=256,activation='relu'))
model.add(keras.layers.Dropout(0.3))
model.add(keras.layers.Dense(units=2,activation='softmax'))
model.summary()
#模型设置与训练
model.compile(optimizer='adam',
loss='categorical_crossentropy',
metrics=['accuracy'])
history = model.fit(x_train, y_train,
validation_split=0.2,
epochs=10,
batch_size=128,
verbose=1)
#训练过程可视化
import matplotlib.pyplot as plt
acc=history.history['accuracy']
val_acc=history.history['val_accuracy']
loss=history.history['loss']
val_loss=history.history['val_loss']
epochs=range(1,len(acc)+1)
plt.plot(epochs,loss,'r',label='Training loss')
plt.plot(epochs,val_loss,'b',label='Validation loss')
plt.title('Training and validation loss')
plt.xlabel('Epochs')
plt.ylabel('Loss')
plt.legend()
plt.show()
plt.clf()# clear figure
acc_values=history.history['accuracy']
val_acc_values=history.history['val_accuracy']
plt.plot(epochs,acc,'r',label='Training acc')
plt.plot(epochs,val_acc,'b',label='Validation acc')
plt.title('Training and validation accutacy')
plt.xlabel('Epochs')
plt.ylabel('Accuracy')
plt.legend()
plt.show()
#评估模型准确率
test_loss,test_acc=model.evaluate(x_test,y_test,verbose=1)
print('Test Accuracy',test_acc)
#执行模型预测
predictions=model.predict(x_test)
predictions[0]
#定义预测结果显示函数
sentiment_dict={0:'pos',1:'neg'}
def display_test_sentiment(i):
print(test_texts[i])
print('label values:',sentiment_dict[np.argmax(y_test[i])],'predict value:',sentiment_dict[np.argmax(predictions[i])])
#查看预测结果
display_test_sentiment(0)
1
2
3
tf.keras.layers.Embedding(input_dim, # 输入词汇表的长度,最大词汇数+1
output_dim, # 输出词向量的维度
input_length=None # 输入Tensor的长度

如:
tf.keras.layers.Embedding(input_dim=3000,output_dim=50,input_length=200
输入的整型矩阵size: (batch, 200)
词典的词汇数:3000
输出shape: (batch, 200, 50)

循环神经网络RNN与LSTM介绍

数据的时序与含义
很多问题具有时序性,自然语言处理、视频图像处理、股票交易信息等等
多层全连接的神经网络或者卷积神经网络都只能根据当前的状态进行处理,不能很好地处理时序问题
RNN的模型结构
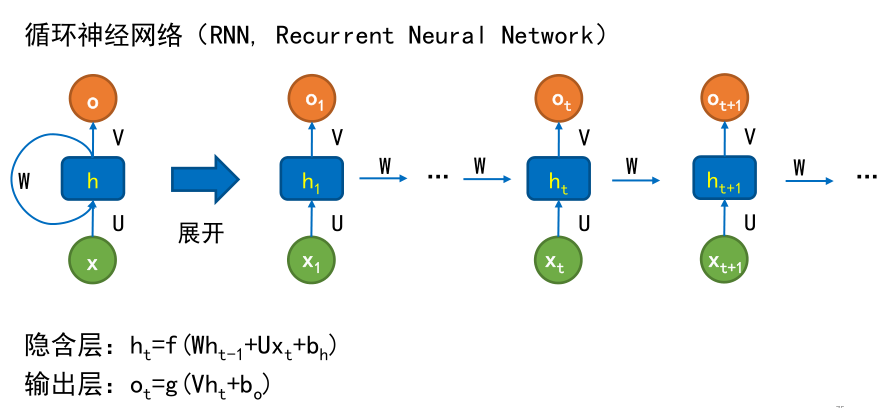
Recurrent Neural Network
普通RNN的不足:
梯度消失与梯度爆炸
长距离依赖问题

LSTM网络结构(改进)
传统RNN每一步的隐藏单元只是执行一个简单的tanh或ReLU操作。
LSTM基本结构和RNN相似,主要不同是LSTM对隐含层进行了改进
在LSMT中,每个神经元相当于一个记忆细胞(Cell)
基本状态
LSTM的关键是细胞的状态,细胞的状态类似于传送带,直接在整个链路上运行,只有一些少量的线性交互
门 (Gate)
LSTM有通过精心设计的称作“门”的结构来去除或者增加信息到细胞状态的能力。
门是一种让信息选择式通过的方法。包含一个Sigmoid神经网络层和一个点乘操作 。
Sigmoid层输出0到1之间的数值,描述每个部分有多少量可以通过。
0 代表“不许任何量通过”
1 代表“允许任何量通过”
LSTM 拥有三个门,来保护和控制细胞状态。
遗忘门:决定丢弃上一步的哪些信息。
该门会读取 ht−1和 xt,输出一个在 0 到 1 之间的数值给每个在细胞状态 Ct−1中的数字。1 表示“完全保留”,0 表示“完全舍弃”
输入门:决定加入哪些新的信息。
tanh层创建一个新的候选值向量 Ct~,加到状态中。
这里sigmoid层称“输入门层”,起到一个缩放的作用。
这两个信息产生对状态的更新。
形成新的细胞状态

  1. 旧的细胞状态 Ct−1与 ft 相乘来丢弃一部分信息
  2. 再加上 it∗Ct~(i是input输入门),生成新的细胞状态Ct
    输出门:决定输出哪些信息。
    把Ct输给 tanh 函数,得到一个候选的输出值
    运行一个 sigmoid 层来确定细胞状态的哪个部分将输出出去
    LSTM相比于RNN的优点:
  3. 梯度下降法中,RNN的梯度求解是累乘的形式,由于LSTM的隐含层更复杂,LSTM在梯度求解时,式子是累加的形式,所以LSTM的梯度往往不会是一个接近于0的小值,缓解了梯度消失的问题。
  4. 使用了门结构,解决了长距离依赖的问题。

基于LSTM结构的模型构建

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
#建立模型
model = keras.models.Sequential()
model.add (keras.layers.Embedding(output_dim=32,
input_dim=4000,
input_length=400))
model.add(keras.layers.Bidirectional(keras.layers.LSTM(units=8)))
model.add(keras.layers.Dense(units=32,activation='relu'))
model.add(keras.layers.Dropout(0.3))
model.add(keras.layers.Dense(units=2,activation='softmax'))
model.summary()
#模型设置与训练
model.compile(optimizer='adam',
loss='categorical_crossentropy',
metrics=['accuracy'])
history = model.fit(x_train, y_train,
validation_split=0.2,
epochs=6,
batch_size=128,
verbose=1)